TorchNeuron su AWS Trainium: Eseguire Modelli Hugging Face
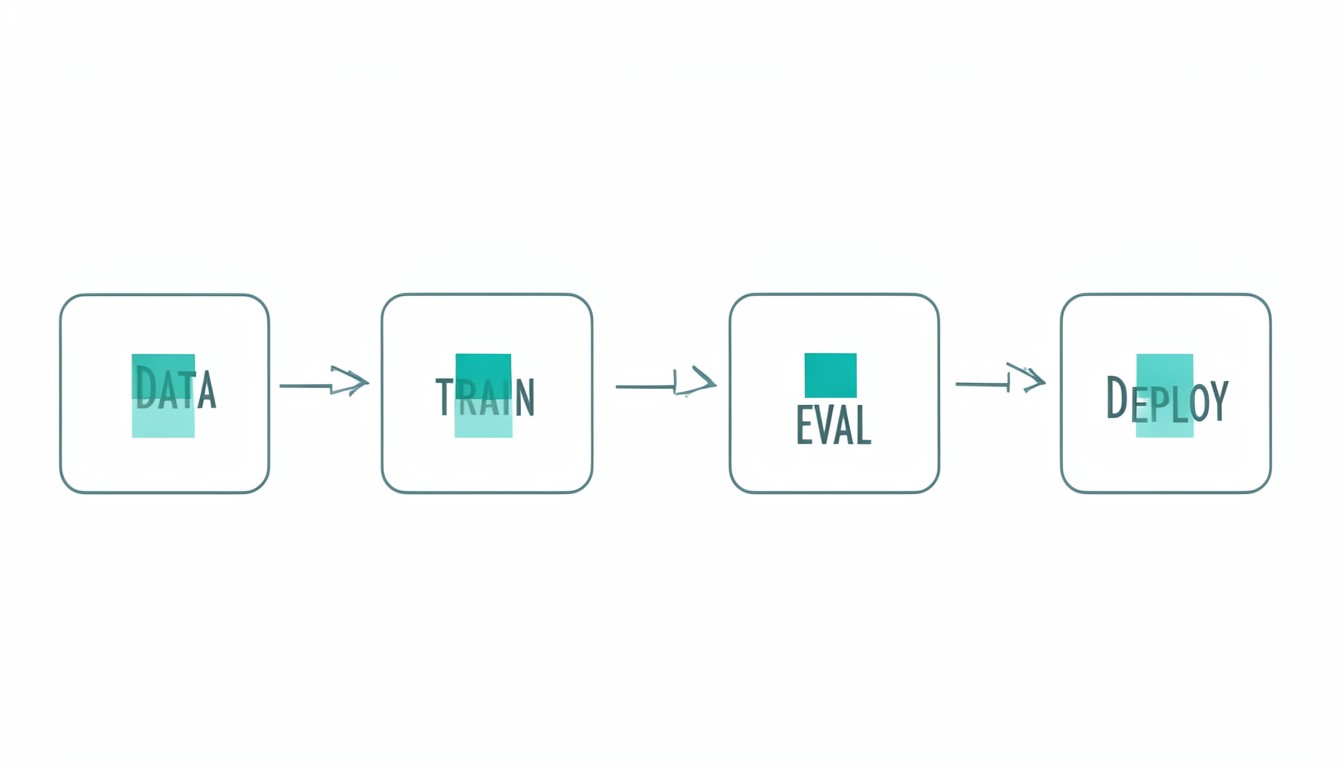
Eseguire modelli Hugging Face (HF) su AWS Trainium? È un grande affare. Per i marketers di crescita, i marketers di performance e chiunque stia costruendo stack di annunci o automazione, ottenere modelli AI ad alta performance deployati in modo efficiente è il nome della partita. TorchNeuron ha reso tutto questo processo molto meno doloroso.
Guarda, il deploy di questi modelli non è una passeggiata. Siete costantemente combattendo problemi di latenza. Poi c'è il problema della scalabilità - cosa succede quando il vostro traffico aumenta? E non iniziamo a parlare dei incubi di integrazione. È un disastro, di solito. TorchNeuron si inserisce per tagliare attraverso quel rumore.
Hanno stabilito una collaborazione con AWS Trainium. Questo hardware è progettato per mangiare macchine di carichi di lavoro di machine learning. Quindi, con TorchNeuron, potete far funzionare i modelli HF su Trainium senza il solito circo. Questo significa meno tempo sprecato con le configurazioni, più tempo per utilizzare effettivamente i modelli.
Qual è il reale beneficio?
- Meno Latenza: I modelli rispondono rapidamente. Critico per qualsiasi cosa in tempo reale, come il targeting pubblicitario o la personalizzazione delle feed utente. Non volete una latenza qui.
- Scalabilità: Si scala. Punto. Le vostre campagne crescono, i vostri modelli seguono. Nessun calo improvviso delle prestazioni perché avete toccato un limite invisibile.
- Integrazione Più Facile: Inserire modelli HF nei vostri sistemi esistenti diventa semplice. Non un'operazione che richiede giorni. Questo salva molto tempo e mantiene il vostro team di sviluppo dalla perdita dei capelli.
- Economicità: Meno farraglie con il deploy significa meno spesa operativa. State ottimizzando il processo; il budget lo apprezza.
Stiamo già vedendo questo in azione. Pensate al targeting pubblicitario: modelli più intelligenti che imparano il comportamento degli utenti in tempo reale, rendendo le campagne più efficaci. E-commerce? Esperienze di shopping personalizzate guidate da modelli che effettivamente comprendono le preferenze dei clienti. Perfino i bot di assistenza clienti diventano più acuti, fornendo risposte migliori e più rapide. Non è magia; è solo migliore ingegneria.
Questo non è un futuro lontano. Sta succedendo ora. Il deploy efficiente di modelli ad alta performance sta diventando un must. Il movimento di TorchNeuron con AWS Trainium? È un chiaro segnale di dove stanno andando le cose: più semplice, più veloce e meno fastidio per chi di noi costruisce e gestisce questi sistemi.